EXPERIMENTO 01 / Recuperación de información
AxiomRAG.
De documentos técnicos a respuestas con contexto. Recuperación híbrida, re-ranking y evaluación de calidad.
EL PROBLEMA
¿Cómo recuperar información sin perder el contexto?
EL ENFOQUE
Combinar búsqueda léxica y semántica, recuperar fragmentos junto a sus documentos padre y evaluar las respuestas generadas.
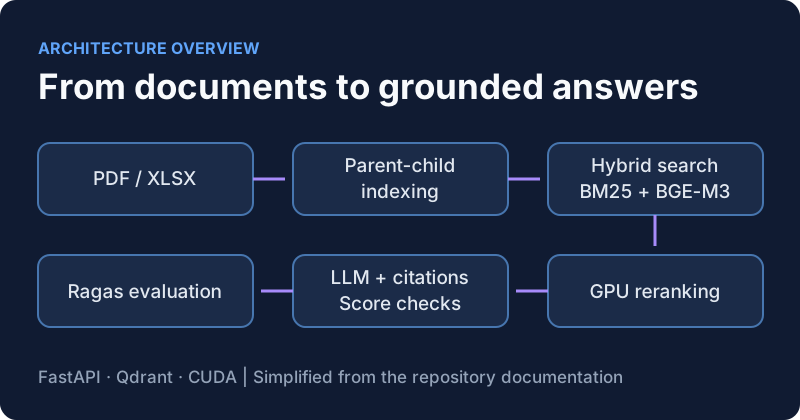
Del documento a la respuesta
AxiomRAG explora una arquitectura RAG asíncrona con énfasis en almacenamiento local. El README documenta ingesta de PDF y XLSX, indexación vectorial en Qdrant y búsqueda híbrida con BM25 y BGE-M3.
La recuperación Parent-Child busca fragmentos específicos e incorpora el documento padre como contexto. Un cross-encoder reordena los resultados antes de la generación. El almacenamiento local no implica que toda la inferencia sea local: la documentación contempla servicios externos de generación.
Qué está documentado
El README reporta una línea base con Ragas: faithfulness de 0.6061 y context precision de 0.6667. Son resultados del entorno de evaluación descrito por el proyecto; no representan una garantía para otros documentos o cargas de trabajo.
También describe pruebas de integración con GPU y LLM, pruebas rápidas de lógica y parsers, y ejecución mediante Docker con soporte NVIDIA CUDA 12.4. Estas pruebas no se han reproducido como parte de esta web.
Qué sigue siendo una pregunta
La recuperación y la evaluación ayudan a detectar fallos, pero no demuestran la eliminación de alucinaciones. La calidad depende del corpus, las consultas y el modelo utilizado. Esta ficha presenta la arquitectura y sus mediciones publicadas, sin asumir validación independiente ni despliegues empresariales.