EXPERIMENTO 02 / Evaluación de modelos
OmniModel Auditor.
Evaluar antes de elegir. Un banco de pruebas para comparar modelos de lenguaje en hardware de consumo.
EL PROBLEMA
¿Qué modelo funciona para una tarea y un equipo concretos?
EL ENFOQUE
Medir precisión, formato JSON, latencia, tokens por segundo y consumo de GPU en una misma evaluación local.
Medir algo más que velocidad
OmniModel Auditor ejecuta evaluaciones de LLM mediante Ollama. El entorno descrito utiliza una NVIDIA RTX 3060 de 6 GB y registra telemetría con GPUtil.
Además de precisión y rendimiento, examina si las respuestas cumplen el esquema JSON solicitado. Si el formato falla, una extracción mediante expresiones regulares intenta recuperar la respuesta para separar el acierto semántico del cumplimiento de formato.
Evidencia disponible
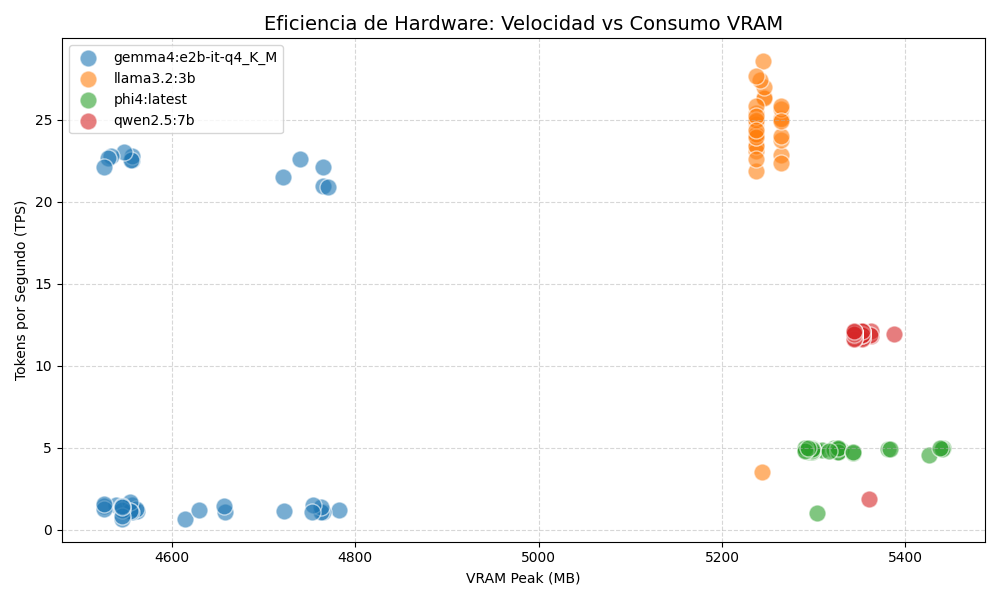
El repositorio contiene un dataset técnico con respuestas de referencia, archivos de resultados y gráficos. La imagen de esta ficha procede de esos materiales; no es una medición realizada por la web.
Los scripts benchmark.py y showcase.py separan la ejecución de la auditoría y la generación de visualizaciones. El README documenta comparaciones de Gemma 4 E2B, Llama 3.2 3B, Phi-4 y Qwen 2.5 7B.
Alcance del experimento
Es una demostración técnica de evaluación local. Los resultados dependen de la cuantización, las versiones de los modelos, los casos evaluados y el hardware. No constituyen un ranking universal ni certifican el comportamiento en producción. No se han vuelto a ejecutar los benchmarks para preparar esta web.